加入支持让我们有继续维护的动力!会员畅享查看所有预告
立即购买
A data-augmented predictive framework for generating fair synthetic labels with controlled fairness-faithfulness trade-offs
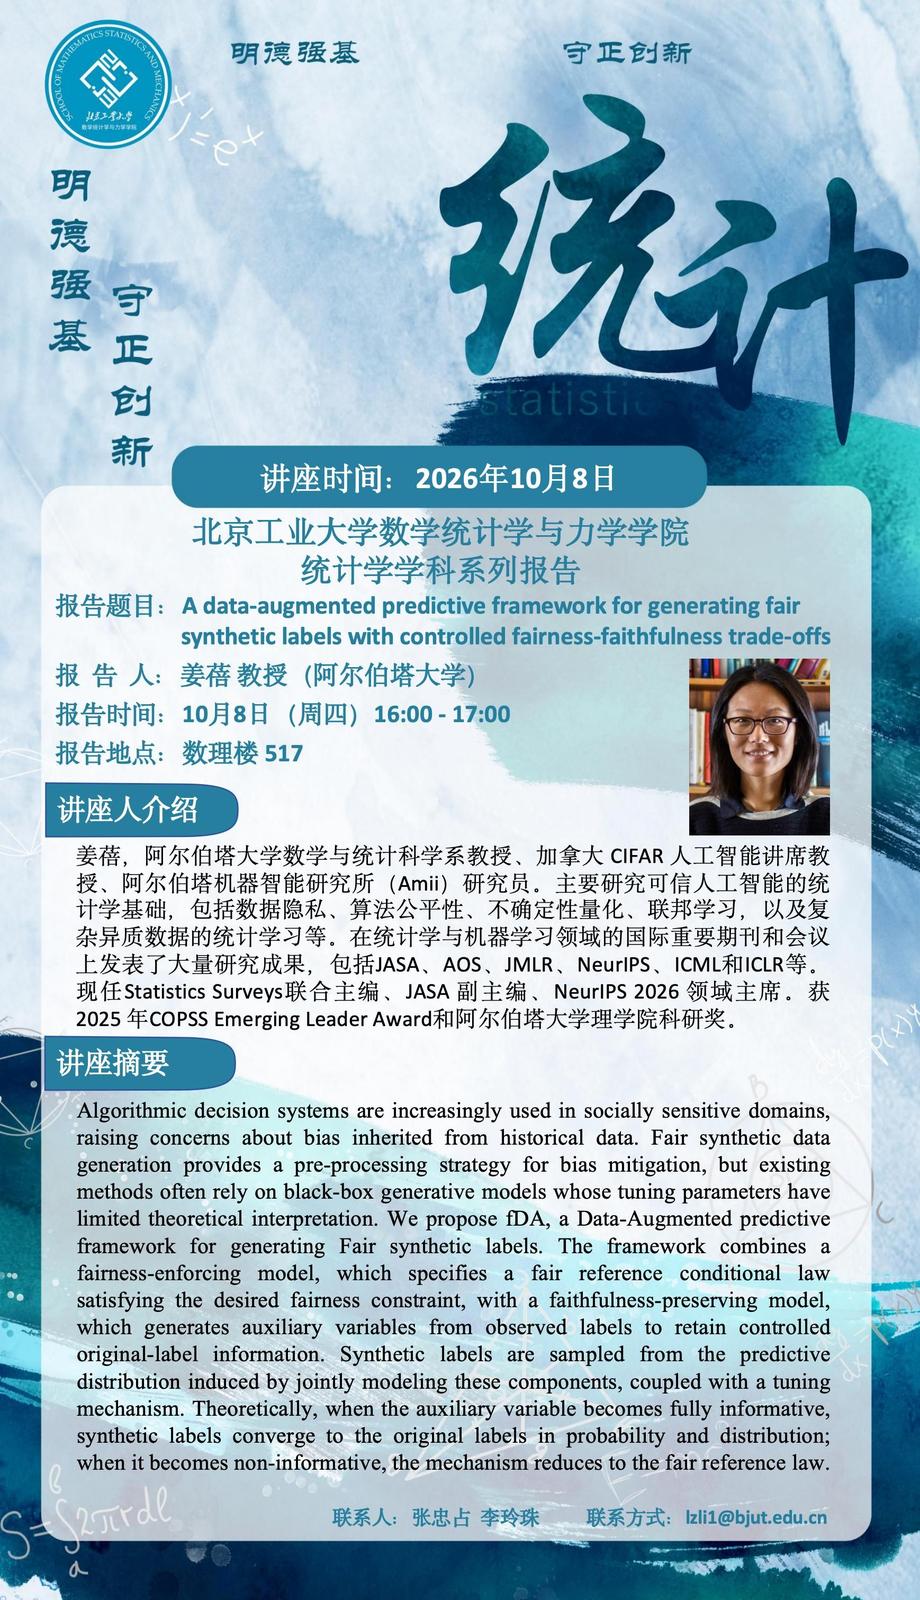
本次讲座将介绍一种数据增强的预测框架fDA,用于生成具有可控公平性-保真性权衡的公平合成标签,旨在缓解算法决策系统中的历史数据偏见。
报告介绍
算法决策系统在社会敏感领域的广泛应用引发了对历史数据偏见继承的担忧。公平合成数据生成是一种前置的去偏策略,但现有方法多依赖黑箱生成模型,其调参缺乏理论解释。本报告将提出fDA框架,结合满足公平性约束的公平参考条件模型与保留原始标签信息的保真模型,通过联合建模生成合成标签,并引入调节机制控制公平性与保真性之间的权衡。
理论上,当辅助变量完全有效时,合成标签依概率和分布收敛于原始标签;当其无效时,机制退化为公平参考律。
报告人介绍
姜蓓,阿尔伯塔大学数学与统计科学系教授、加拿大CIFAR人工智能讲席教授、阿尔伯塔机器智能研究所(Amii)研究员。主要研究可信人工智能的统计学基础,包括数据隐私、算法公平性、不确定性量化、联邦学习,以及复杂异质数据的统计学习等。在JASA、AOS、JMLR、NeurIPS、ICML和ICLR等国际重要期刊和会议上发表大量研究成果。
现任Statistics Surveys联合主编、JASA副主编、NeurIPS 2026领域主席。获2025年COPSS Emerging Leader Award和阿尔伯塔大学理学院科研奖。
报告图片 共 1 张