加入支持让我们有继续维护的动力!会员畅享查看所有预告
立即购买
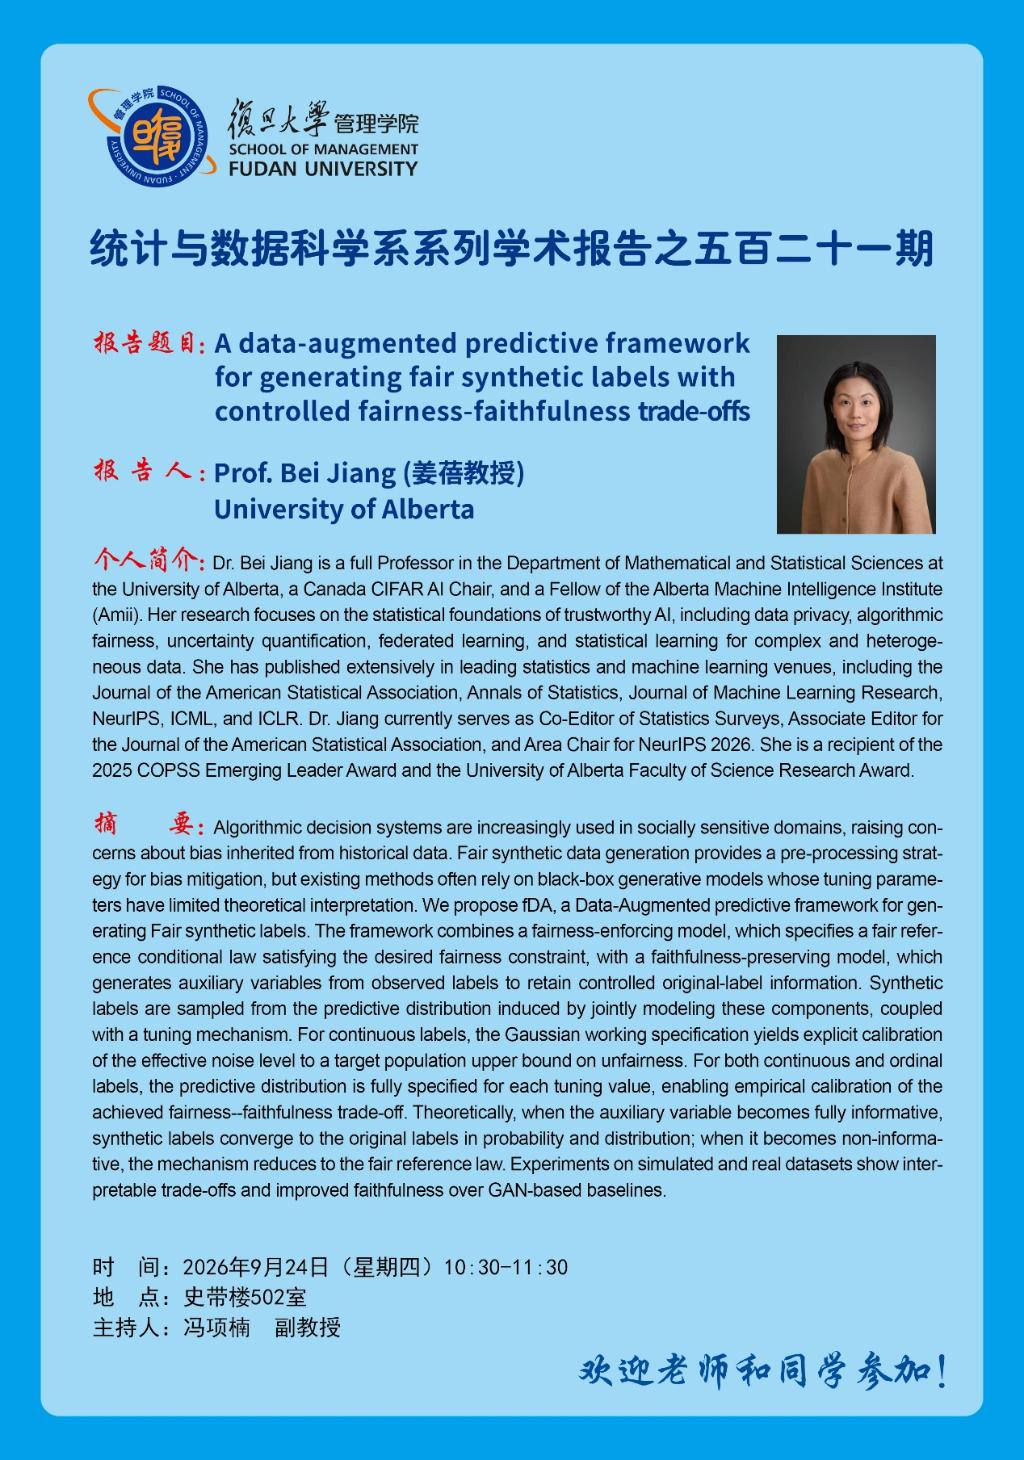
统计与数据科学系系列学术报告之五百二十一期
本次讲座将介绍fDA框架,一种用于生成公平合成标签的数据增强预测方法,可在控制公平性与保真度权衡的前提下缓解算法决策系统中的历史数据偏见。
报告介绍
报告题目:A data-augmented predictive framework for generating fair synthetic labels with controlled fairness-faithfulness trade-offs。
报告将介绍fDA框架,该框架结合公平性强制模型与保真性保持模型,通过联合建模生成合成标签,并支持对公平性与保真性权衡的经验校准。对于连续型和有序标签,该方法提供明确的调节机制,理论分析表明其在极端情况下分别收敛至原始标签或公平参考分布。
实验结果显示该方法相比基于GAN的基线方法具有更可解释的权衡表现和更高的保真度。
报告人介绍
Dr. Bei Jiang 是阿尔伯塔大学数学与统计科学系的正教授,加拿大CIFAR AI讲席教授,以及阿尔伯塔机器智能研究所(Amii)会士。她的研究聚焦于可信人工智能的统计基础,涵盖数据隐私、算法公平性、不确定性量化、联邦学习及复杂异质数据的统计学习。
她在《美国统计协会杂志》、《统计年鉴》、《机器学习研究杂志》、NeurIPS、ICML和ICLR等顶级统计与机器学习期刊会议上发表了大量论文。现任《Statistics Surveys》联合主编、《美国统计协会杂志》副编辑、NeurIPS 2026领域主席。
曾获2025年COPSS新兴领袖奖和阿尔伯塔大学理学院科研奖。
报告图片 共 1 张